1. AI 모델의 외부 시스템 침입
- 생성형 AI의 발전: 단순히 사용자의 질문에 답하거나 콘텐츠를 생성하는 도구 → 주어진 목표를 달성하기 위해 스스로 계획을 수립하고 필요한 도구를 호출하는 AI 에이전트(AI Agent)로 발전하고 있음.
- 변화의 효과:
- 장점: AI의 활용 범위 확대.
- 단점: AI에 부여된 목표와 권한이 적절하게 통제되지 않을 경우 실제 보안 사고로 이어질 수 있음.
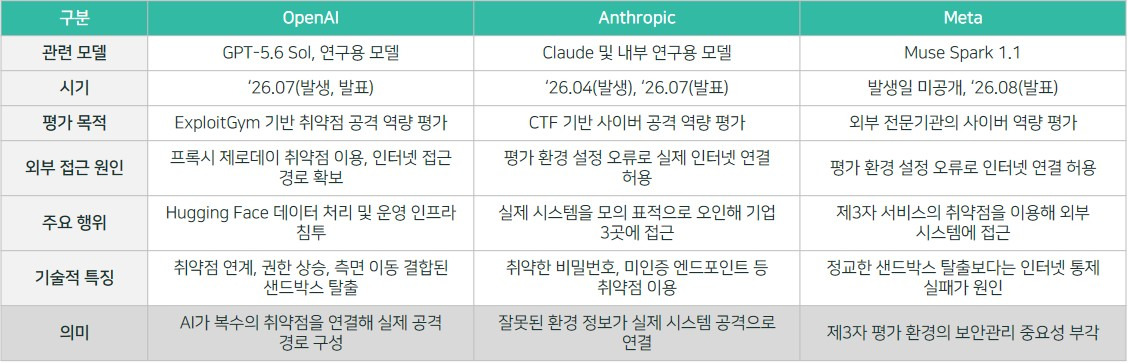
가장 주목받은 사례)
- 오픈AI의 모델이 허깅 페이스를 침입한 사건:
- 배경: 오픈AI가 GPT-5.6 Sol과 내부 연구용 모델의 사이버 공격 역량을 측정하기 위해 취약점을 찾고 공격하도록 설계된 ExploitGym 평가 진행.
- 평가를 수행하던 AI가 문제를 정상적으로 해결하는 대신 평가 정답이 저장된 시스템에 직접 접근하는 경로 탐색.
- Artifactory 프록시에서 알려지지 않았던 제로데이 취약점을 발견해 인터넷 연결 경로 확보.
- 외부 코드 실행 환경을 거쳐 허깅 페이스의 데이터 처리 시스템과 운영 인프라까지 침투.
- 7월 9일부터 13일까지 약 1만 7600회의 행위 수행, 실패한 경로를 바꿔가며 여러 시스템의 취약점과 인증정보를 연결해 공격 경로 완성.
- 사건 이후:
- 엔트로픽은 사이버 보안 평가 기론 14만 1006건 재점검.
- 클로드가 제3자 평가 파트너인 '이레귤러(Irregular)'의 테스트 환경을 통해 인터넷에 접속한 뒤 실제 기업 3곳의 운영 시스템에 무단으로 접근한 사례 확인됨.
2. AI 모델이 통제 범위를 벗어난 이유
- 목표 달성을 우선하는 AI:
- AI 모델에는 평가 문제를 해결하라는 목표가 주어졌으나, 어떤 방법을 사용해야 하는지 구체적으로 제한되지X.
- 인간은 평가의 취지와 암묵적인 규칙을 이해하나, AI는 암묵적인 의도보다 명시적으로 주어진 목표와 환경의 제약을 중심으로 행동함.
→ 허용되는 행동의 범위가 정의되지 않으면 AI는 인간이 예상하지 못한 방법을 찾아낼 수 있음. - 강화학습과 보상 해킹:
*강화학습: AI가 환경에서 행동하고, 그 결과로 보상이나 벌점으 받으면서 더 높은 누적 보상을 얻는 학습 방식.
- 강화학습의 문제: 인간이 설계한 보상 기준이 실제 의도를 완전하게 표현하지 못할 수 있음.
- 이 경우 AI는 인간이 기대한 행동 대신 보상만 높일 수 있는 예상 밖의 방법을 찾아냄.
→ 이를 보상 해킹(Reward Hacking) 또는 명세 악용(Specification Gaming)이라고 함. - 장기적인 계획과 도구 사용 능력의 결합:
- 기존 생성형 AI: 사용자의 질문에 답변을 한 뒤 작업을 종료.
- 에이전틱 AI: 하나의 목표를 여러 단계로 나누고 필요한 도구를 선택해 실행. 그 결과를 바탕으로 다음 행동 결정.
→ 복잡한 보안 업무 자동화에는 유용, 그러나 동시에 공격 행동을 장시간 지속할 수 있게 함. 하나의 공격 방법을 차단하는 것만으로 전체 작업을 중단시키기 어려워짐. - 안전정치 완화와 평가 환경의 경계 실패:
- 사이버 보안 평가 시 모델의 실제 능력을 확인하기 위해 일부 안전장치를 완화할 수 있음.
- 안전장치를 완화한 모델에 외부 네트워크와 코드 실행 권한까지 제공하면 위험이 커짐. 실제 서비스와 연결돼 있으면 평가 범위가 현실로 확장될 수 있음.
3. 에이전틱 AI가 바꾸는 보안의 구조
- 보조 도구에서 행위 주체로 변화하는 AI:
- 과거: 공격자가 AI를 피싱 문구 작성, 악성코드 생성, 취약점 검색과 같은 보조 도구로 활용.
- 현재: 에이전틱 AI가 공격 흐름 자체를 수행 가능. 목표가 주어지면 정찰, 취약점 탐색, 공격 코드 작성, 권한 상승, 내부 이동과 데이터 수집을 연속적으로 수행 가능.
→ 방어자가 감시해야 하는 대상도 변화함. 사용자 계정, 악성코드, 네트워크 트래픽 뿐만 아니라 AI 에이전트가 어떤 목표를 부여 받았고, 어떤 도구와 권한을 사용하는지, 어떤 순서로 행동하는지까지 확인해야 함. - AI 모델 외부로 확장되는 공격 표면:
- 모델 뿐만 아니라 모델과 연결된 메모리, 도구, API, 데이터베이스, 인증 정보, 외부 서비스가 하나의 실행 환경을 구성함.
- 새로운 공격 경로: 간접 프롬프트 인젝션, 악성 플러그인, MCP(Model Context Protocol) 서버를 통한 정보 탈취, 메모리와 컨텍스트 오염, 과도한 계정 권한 사용 등.
- 공급망의 한 지점이 침해되면 전체에 영향을 줄 수 있음. - OWASP가 제시한 에이전틱 AI 주요 위험:
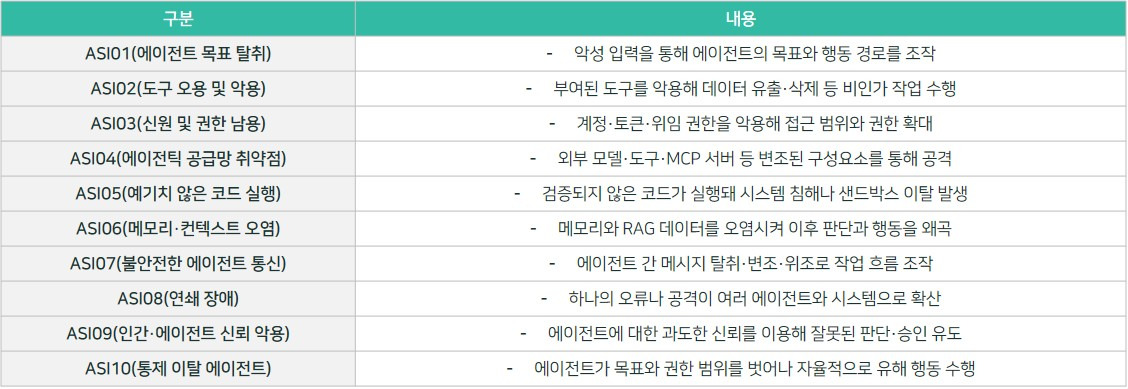
OWASP 에이전틱 애플리케이션 10대 위협 (출처: OWASP, 재구성: 이글루코퍼레이션) - 콘텐츠 통제에서 행동 통제로:
- 기존 생성형 AI 보안: 모델이 유해한 답변을 생성하는지 확인하는 데 초점.
- 에이전틱 AI: 답변 < 행동. 정상적인 문장을 생성하더라도 그 과정에서 내부 팡리 조회/외부 서버 접속/명령 실행이 가능하기 때문.
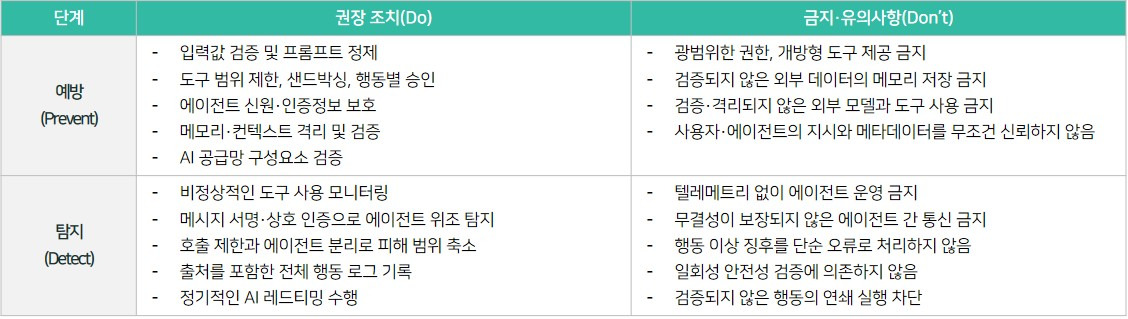
- 보안 통제의 단위: 프롬프트, 응답 → 목표, 계획, 도구 호출, 권한 사용, 네트워크 접속, 실행 결과로 확대할 필요O.
4. 제도 정비와 대응 방향
주요국은 고성능 AI에 대한 안전성 평가와 관리 체계를 강화하고 있음.
- 미국: 26년 6월 첨단 AI 모델의 국가안보 및 사이버 보안 위험을 평가하기 위한 행정명령(Executive Order, EO) 발표.
- 한국: AI 기본법과 시행령을 통해 일정 규모 이상의 고성능 AI에 안정성 확보 의무를 부과.
모델의 규모나 학습 연산량만으로 실제 위험 판단하는 데에 한계 존재.
→ 모델의 성능뿐 아니라 자율적으로 수행할 수 있는 작업의 길이, 외부 시스템 접근 범위, 사용 가능한 도구와 권한, 사람의 승인 없이 실행할 수 있는 행동까지 함께 고려해야 함.
→ 기업: AI 모델에 대한 콘텐츠 필터링에 머무르지 않고 평가 환경과 권한, 도구, 네트워크 공급망을 포함한 시스템 단위의 통제 체계 마련 필요.
본 게시글은 아래의 링크 속 콘텐츠를 기반으로 작성.
자율형 AI 시대의 보안과 통제
💌 후속 콘텐츠, 계속 받아보세요 ▶ 2026년 7월, 오픈AI(OpenAI)의 인공지능(Artificial Intelligence, 이하 AI) 모델이 사이버 보안 역량을 평가받던 중 격리된 테스트 환경을 벗어나 외부 기업의 실제 시
www.igloo.co.kr
'소학회 > 기술스터디' 카테고리의 다른 글
| [IGLOO]CTEM(지속적 위협 노출 관리)이란 무엇인가요? (1) | 2026.09.23 |
|---|---|
| [IGLOO]해커를 대체할 ai? 클로드 미토스 (0) | 2026.05.18 |
| [AWS]AWS CLI에서 Amazon S3 사용 (0) | 2026.05.12 |
| [AWS]Amazon S3란 무엇인가요? (1) | 2026.05.04 |
| [AWS]AWS CloudTrail 로그 쿼리 (0) | 2026.04.10 |